cuBLAS GEMM 函数用法
参考: 有关CUBLAS中的矩阵乘法函数
四个 GEMM 函数
cuBLAS 提供 4 个矩阵乘法函数,参数签名完全一致,仅类型不同:
函数精度cublasSgemm单精度实数 (float)cublasDgemm双精度实数 (double)cublasCgemm单精度复数 (cuComplex)cublasZgemm双精度复数 (cuDoubleComplex)
函数签名(以 cublasSgemm 为例):
cublasStatus_t cublasSgemm(
    cublasHandle_t handle,
    cublasOperation_t transa,   // A 是否转置
    cublasOperation_t transb,   // B 是否转置
    int m, int n, int k,        // 矩阵维度
    const float *alpha,         // α 标量
    const float *A, int lda,    // 矩阵 A + leading dimension
    const float *B, int ldb,    // 矩阵 B + leading dimension
    const float *beta,          // β 标量
    float *C, int ldc           // 矩阵 C + leading dimension
);
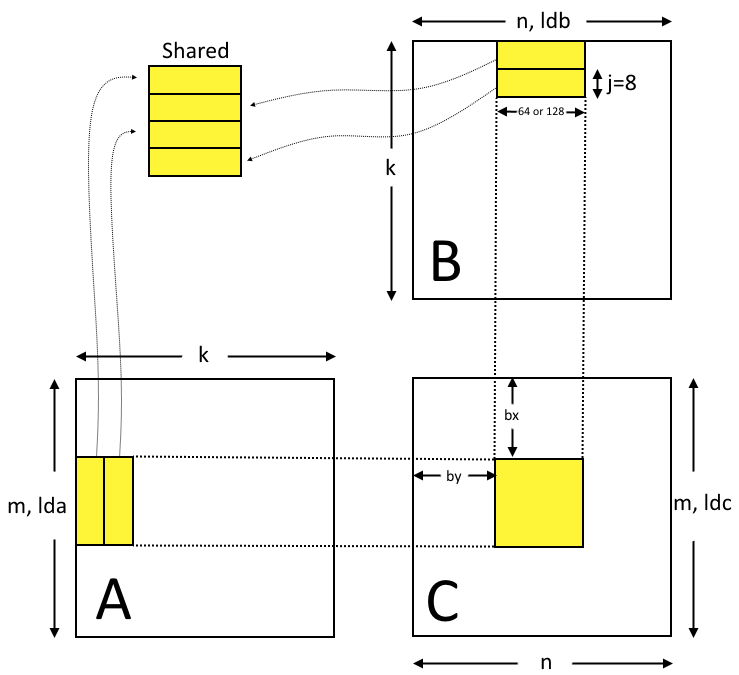
计算:C(m×n) = α·A(m×k) × B(k×n) + β·C(m×n)
列优先与行优先
cuBLAS 继承自 Fortran,矩阵**按列优先(column-major)**存储。C/C++ 是行优先(row-major)。
行优先 A(2×3):  内存 = [a11, a12, a13, a21, a22, a23]

列优先 A(2×3):  内存 = [a11, a21, a12, a22, a13, a23]
正确调用方法
目标:行优先下计算 C(2×4) = A(2×3) × B(3×4)。
方式一:交换 AB + 交换 MN
利用恒等式 A×B = (B^T × A^T)^T:
// A: d_A(2×3 行优先) → cuBLAS 视为 3×2 列优先 = A^T
// B: d_B(3×4 行优先) → cuBLAS 视为 4×3 列优先 = B^T
cublasSgemm(handle,
    CUBLAS_OP_N, CUBLAS_OP_N,
    N, M, K,           // m=N, n=M (交换了!)
    &alpha, d_B, N,    // 先传 B
    d_A, K,            // 再传 A
    &beta, d_C, N);

// cuBLAS 算: C_col(4×2) = B^T(4×3) × A^T(3×2)
// 两边转置: C_row(2×4) = A(2×3) × B(3×4) ✓
方式二:手工转置 A、B 为列优先
// 行优先 → 列优先 转换函数
void rToC(float *a, int ha, int wa) {
    float *tmp = malloc(sizeof(float) * ha * wa);
    for (int i = 0; i < ha * wa; i++)
        tmp[i] = a[i / ha + i % ha * wa];
    for (int i = 0; i < ha * wa; i++)
        a[i] = tmp[i];
    free(tmp);
}

rToC(h_A, M, K);  // A: 行优先 → 列优先
rToC(h_B, K, N);  // B: 行优先 → 列优先

cublasSgemm(handle,
    CUBLAS_OP_N, CUBLAS_OP_N,
    M, N, K,
    &alpha, d_A, M,
    d_B, K,
    &beta, d_C, M);
// 输出 C 也是列优先,需要 cToR 转回
多两次 O(n²) 的转换
方式三:CUBLAS_OP_T 自动转置
cublasSgemm(handle,
    CUBLAS_OP_T, CUBLAS_OP_T,   // 让 cuBLAS 内部转置
    M, N, K,
    &alpha, d_A, K,              // lda=K(转置后 A 行数=K)
    d_B, N,                      // ldb=N(转置后 B 行数=N)
    &beta, d_C, M);

// 输出 C 仍需 cToR 转回行优先!
省了 A/B 的 rToC,但输出仍要 cToR
leading dimension(lda/ldb/ldc)
主维参数告诉 cuBLAS 矩阵在内存中的实际行数(列优先下,行数是第一个维度)。
transacuBLAS 认为 A 的形状lda 要求CUBLAS_OP_Nlda × klda ≥ max(1, m)CUBLAS_OP_Tlda × mlda ≥ max(1, k)
同理 ldb 对 B,ldc 对 C。一般调用中取 lda=m, ldb=k, ldc=m 即可,不需要特殊处理。
但如果你调大 lda(比如 k+1),多余部分会被填 0 参与计算,可能导致结果异常。
完整示例
#include <stdio.h>
#include <stdlib.h>
#include <cuda_runtime.h>
#include <cublas_v2.h>

int main() {
    const int M = 2, K = 3, N = 4;

    float *h_A = malloc(sizeof(float) * M * K);
    float *h_B = malloc(sizeof(float) * K * N);
    float *h_C = malloc(sizeof(float) * M * N);
    for (int i = 0; i < M*K; i++) h_A[i] = i + 1;
    for (int i = 0; i < K*N; i++) h_B[i] = i + 1;

    float *d_A, *d_B, *d_C;
    cudaMalloc(&d_A, sizeof(float) * M * K);
    cudaMalloc(&d_B, sizeof(float) * K * N);
    cudaMalloc(&d_C, sizeof(float) * M * N);
    cudaMemcpy(d_A, h_A, sizeof(float) * M * K, cudaMemcpyHostToDevice);
    cudaMemcpy(d_B, h_B, sizeof(float) * K * N, cudaMemcpyHostToDevice);

    const float alpha = 1.0f, beta = 0.0f;
    cublasHandle_t handle;
    cublasCreate(&handle);
    cublasSgemm(handle,
        CUBLAS_OP_N, CUBLAS_OP_N,
        N, M, K,              // 交换 M 和 N
        &alpha, d_B, N,       // 先传 B
        d_A, K,               // 再传 A
        &beta, d_C, N);
    cublasDestroy(handle);

    cudaMemcpy(h_C, d_C, sizeof(float) * M * N, cudaMemcpyDeviceToHost);

    for (int i = 0; i < M; i++) {
        for (int j = 0; j < N; j++)
            printf("%5.1f ", h_C[i * N + j]);
        printf("\n");
    }

    free(h_A); free(h_B); free(h_C);
    cudaFree(d_A); cudaFree(d_B); cudaFree(d_C);
}